소넷 5.5의 가격표를 보면 마음이 쉽게 기웁니다. 100만 토큰당 입력 $2, 출력 $10으로 오퍼스 5.5의 정확히 절반이기 때문입니다. 그런데 한 작업을 끝까지 시키는 데 든 총비용을 잰 외부 측정에서는 소넷 5.5가 약 $7.60, 오퍼스 5.5가 약 $5.98로 나왔습니다. 단가는 절반인데 작업당 비용은 27% 더 나온 셈입니다. 이 글은 이 어긋남이 무슨 뜻인지, 그리고 두 모델을 어떻게 고르면 좋을지를 정리합니다.
목차
먼저 밝힙니다. 이 글은 2026년 9월 29일에 Anthropic의 두 공식 페이지와 외부 평가 기관 Artificial Analysis의 글을 읽고 정리한 분석입니다. 점수는 대부분 Anthropic이 스스로 밝힌 값이라 측정 조건이 서로 다를 수 있습니다. 제가 직접 돌려 본 비교는 오퍼스 5.5와 아스트라의 네 과제뿐이고, 소넷 5.5는 그 과제에 넣지 않았습니다.
소넷 5.5와 오퍼스 5.5의 단가는 얼마나 다른가요?
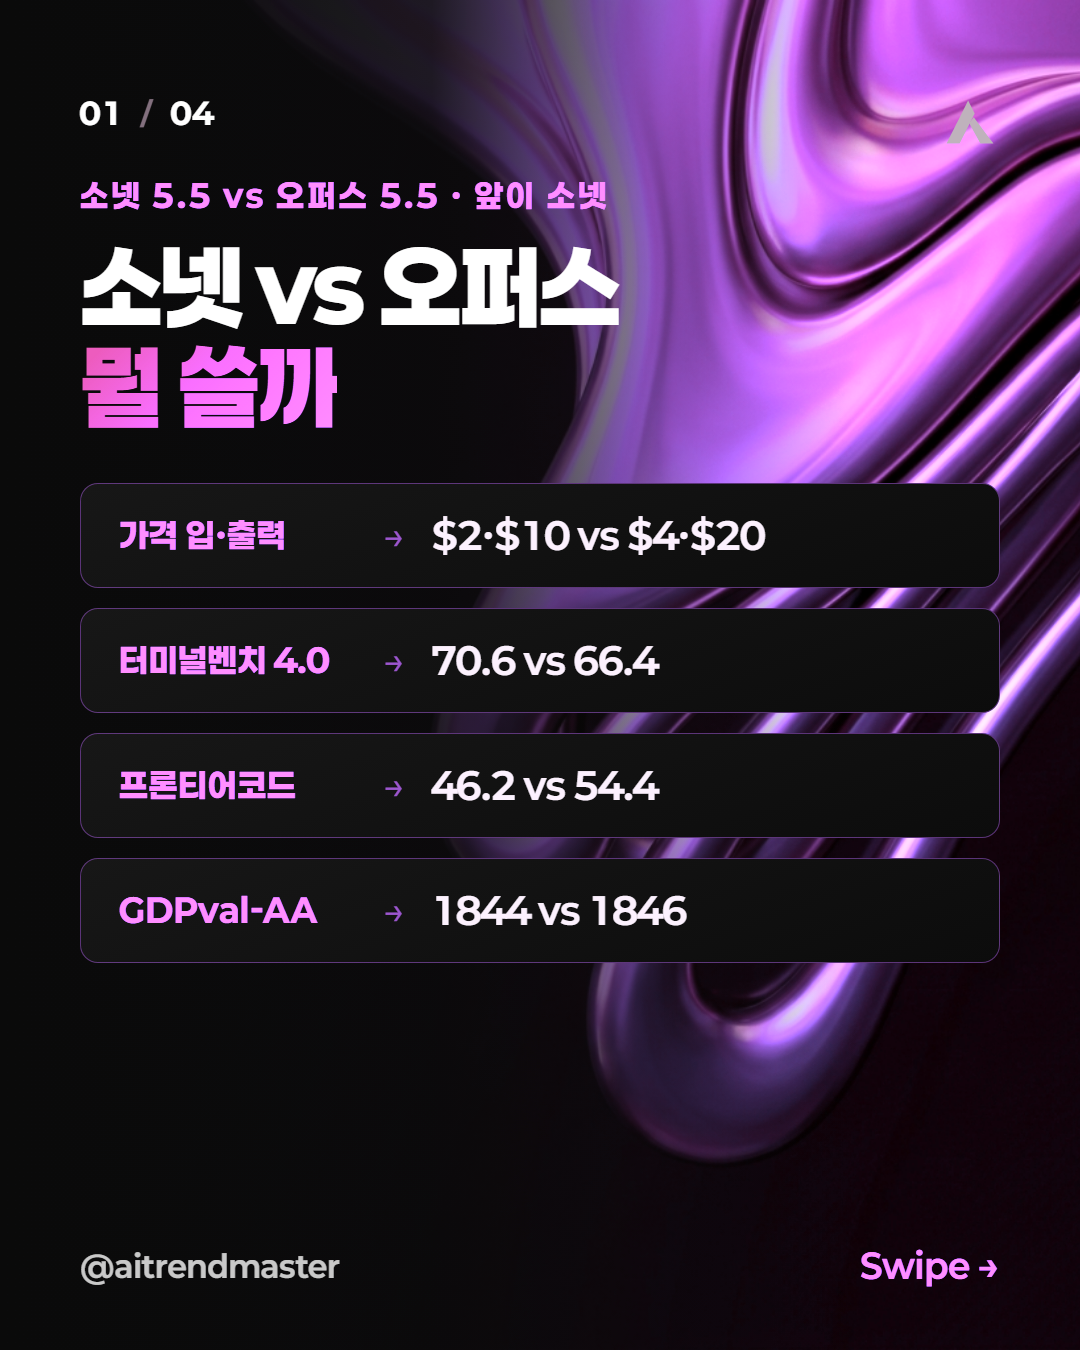
Anthropic 공식 페이지 기준으로 100만 토큰당 가격은 아래와 같습니다. 토큰이 낯설다면 “AI가 글을 세는 단위이고 요금은 100만 개당 매긴다”라고만 이해하셔도 충분합니다.
| 모델 | 입력 | 출력 | 비고 |
|---|---|---|---|
| 소넷 5.5 | $2 | $10 | 일상 작업용으로 안내 |
| 오퍼스 5.5 | $4 | $20 | 판단이 필요한 복잡한 작업용으로 안내 |
입력과 출력 모두 정확히 2배 차이입니다. 그래서 같은 양을 읽고 쓴다면 소넷 5.5가 절반 가격이라는 계산이 성립합니다. 문제는 “같은 양을 읽고 쓴다”는 전제가 실제 작업에서는 잘 맞지 않는다는 점입니다.
공식 점수는 어느 쪽이 높은가요?
Anthropic이 두 모델 페이지에서 밝힌 점수를 나란히 놓았습니다. 표의 숫자는 모두 자체 보고이며, 항목마다 측정 방식이 다릅니다.
| 항목 | 소넷 5.5 | 오퍼스 5.5 | 앞선 쪽 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6 | 66.4 | 소넷 |
| CursorBench | 55.5 | 57.8 | 오퍼스 |
| FrontierCode | 46.2 | 54.4 | 오퍼스 |
| GDPval-AA | 1844 | 1846 | 사실상 동률 |
| HLE (도구 사용) | 64.5 | 67.7 | 오퍼스 |
다섯 항목 중 소넷이 앞선 것은 하나이고, 하나는 사실상 동률이며, 세 항목에서는 오퍼스가 앞섭니다. 격차도 항목마다 제각각입니다. FrontierCode는 8점 넘게 벌어졌지만 GDPval-AA는 2점 차이입니다. 어느 한쪽이 전부 낫다고 말하기 어려운 그림입니다.
단가가 절반인데 작업당 비용은 왜 더 나오나요?
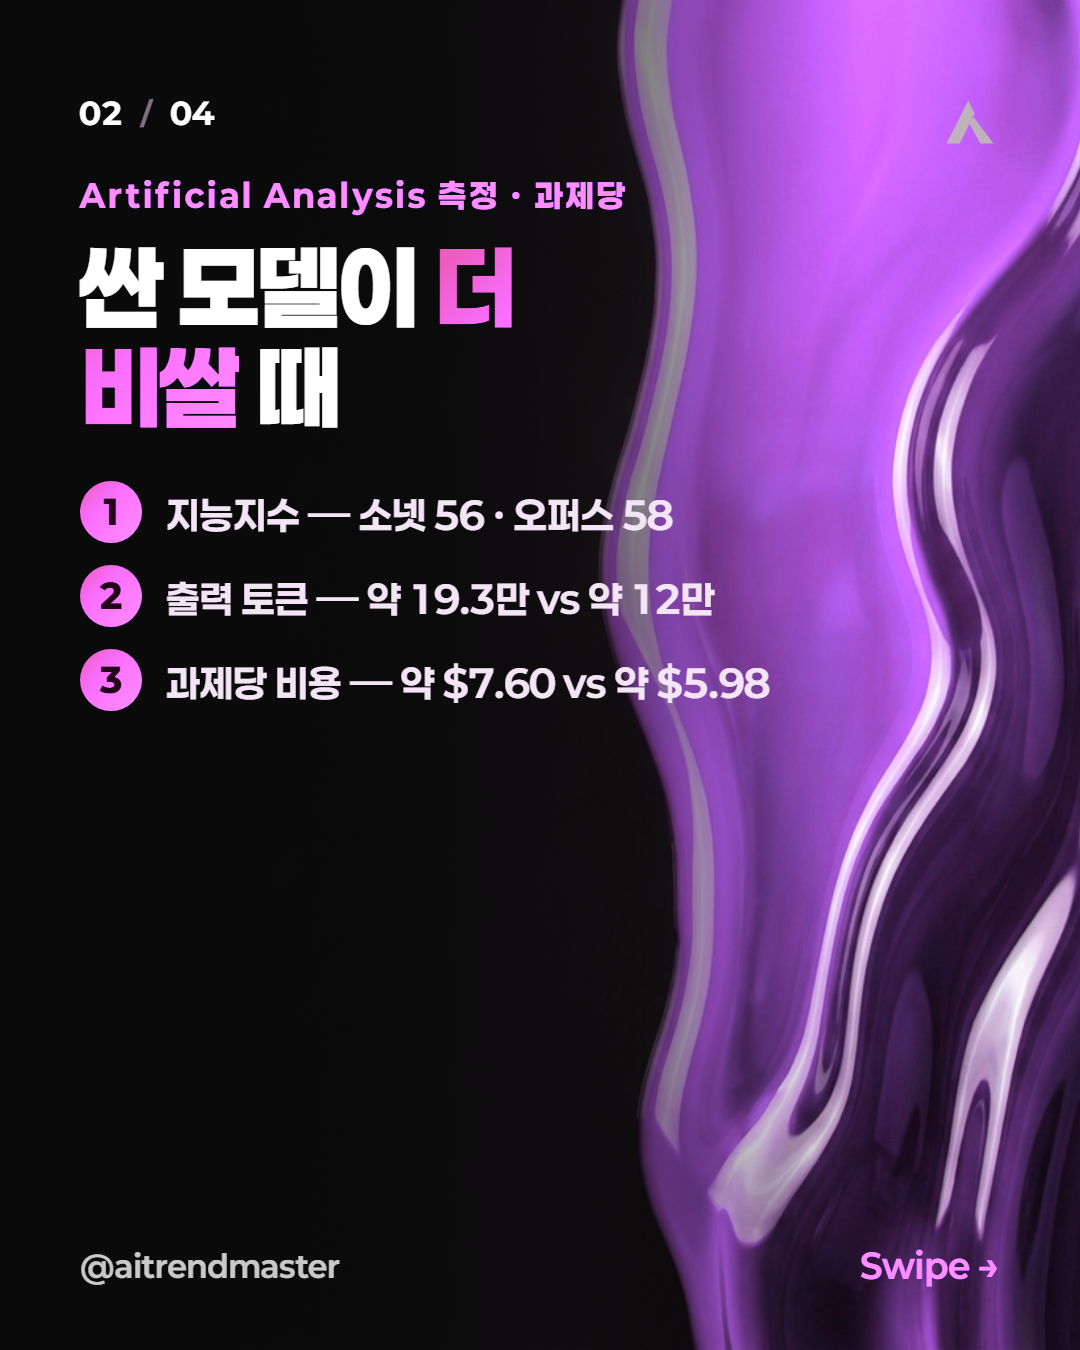
Artificial Analysis가 같은 벤치마크 묶음을 두 모델에 돌려 한 작업당 평균을 낸 수치가 있습니다.
| 항목 | 소넷 5.5 | 오퍼스 5.5 |
|---|---|---|
| 작업당 출력 토큰 | 약 193k | 약 120k |
| 작업당 비용 | 약 $7.60 | 약 $5.98 |
| 종합 지수 | 56 | 58 |
소넷 5.5가 한 작업에 쓴 출력 토큰은 오퍼스 5.5의 약 1.61배입니다. 단가가 절반이어도 더 많이 쓰면 절약이 사라진다는 이야기입니다. 여기서 주의할 점이 둘 있습니다. 하나는 이 표가 벤치마크 한 묶음의 결과라서 내 작업에 그대로 옮겨지지 않는다는 것입니다. 다른 하나는 총비용을 입력과 출력으로 쪼개 주는 수치가 원문에 없어서, 비용이 왜 그렇게 나왔는지 저는 추정하지 않는다는 것입니다.
30% 절감이라는 문구는 무엇과 비교한 값인가요?
Anthropic 소개글에는 소넷 5.5로 작업당 최대 30% 덜 든다는 취지의 표현이 있습니다. 이 비교 대상은 오퍼스 5.5가 아니라 이전 세대인 소넷 5입니다. 위 표와 정면으로 부딪히는 이야기가 아니라 기준점이 다른 이야기입니다. 문구를 읽을 때는 “무엇보다 30%인가”를 꼭 확인하세요.
초기 사용 기업들은 무엇이라고 말했나요?
공식 페이지에 실린 초기 사용 기업의 말도 있습니다. 전부 기업 스스로 밝힌 값이라, 참고 정도로만 읽어야 합니다.
- Slack: 출력 토큰이 14% 줄었다고 밝혔습니다.
- Zendesk: 응답이 20% 빨라졌다고 밝혔습니다.
- Box: 처리 속도가 2.4배가 되었다고 밝혔습니다.
- Lovable: 도구 호출이 3분의 1 줄었다고 밝혔습니다.
네 곳 모두 무엇과 비교했는지, 어떤 작업이었는지가 짧은 소개글에 다 담기지 않습니다. 이 수치들은 “이런 방향의 보고가 있었다”는 정도로만 받아 두시는 편이 안전합니다.
그래서 소넷 5.5와 오퍼스 5.5는 어떻게 고르나요?
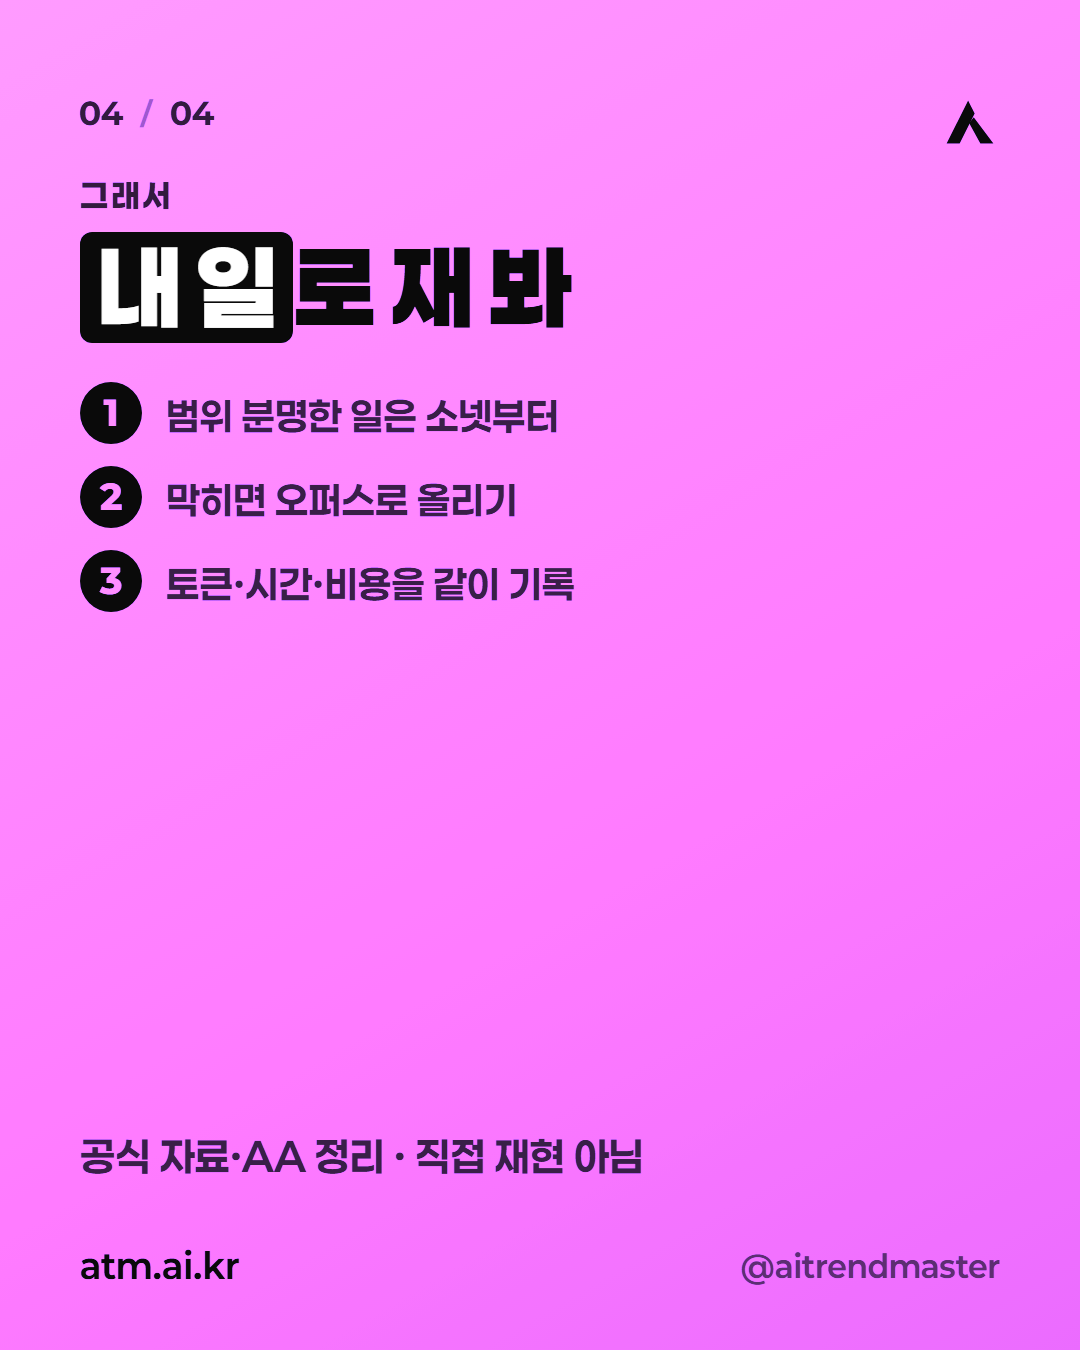
Anthropic의 안내는 단순합니다. 판단이 필요한 복잡한 작업은 오퍼스 5.5, 범위가 분명한 일상 작업은 소넷 5.5입니다. 위의 수치를 함께 보면 이런 순서로 정할 수 있습니다.
- 작업 하나를 고릅니다. 평소에 자주 시키는 일이면 좋습니다.
- 같은 지시문을 두 모델에 시키고 걸린 시간과 토큰, 결과물 품질을 기록합니다.
- 토큰 단가가 아니라 작업 한 건의 총비용을 비교합니다.
- 결과가 비슷하고 비용이 낮은 쪽을 그 종류의 작업에 쓰고, 어려운 작업만 다른 모델로 넘깁니다.
단가로 비용을 계산해 보는 방식은 AI 자동화 비용 계산 글에서 다른 모델로 다룬 적이 있고, 실제 과제를 두 모델에 시켜 본 방식은 아스트라와 오퍼스 5.5 비교 글에 남겨 두었습니다.
자주 묻는 질문
소넷 5.5가 오퍼스 5.5보다 항상 싼가요?
토큰 단가는 절반이지만, 작업 하나에 드는 총비용은 쓰는 토큰 양에 달려 있습니다. Artificial Analysis의 한 측정에서는 소넷 5.5의 작업당 비용이 더 나왔습니다. 내 작업에서 직접 재 보는 것이 가장 정확합니다.
소넷 5.5의 점수는 오퍼스 5.5보다 낮은가요?
항목마다 다릅니다. 공식 표에서 Terminal-Bench는 소넷이 앞서고 FrontierCode는 오퍼스가 크게 앞섭니다. 하나의 숫자로 우열을 정하기 어렵습니다.
이 글의 수치는 제가 직접 측정한 건가요?
아닙니다. Anthropic 공식 페이지와 Artificial Analysis 글을 읽고 정리한 값이며, 재현하지 않았습니다.
오늘 다룬 두 모델 원문 바로가기
- 소넷 5.5 소개 페이지 원문 — 점수와 초기 사용 기업 문구
- Artificial Analysis 소넷 5.5 분석 글 — 작업당 비용 측정
- 오퍼스 5.5 소개 페이지 원문 — 단가표와 Fast 모드
출처
| 항목 | 출처 |
|---|---|
| 단가, 벤치마크 점수, 초기 사용 기업 문구 | Anthropic 공식 페이지 (2026-09-29 확인) |
| 작업당 출력 토큰, 작업당 비용, 종합 지수 | Artificial Analysis 분석 글 |
| 27%, 1.61배 | 위 두 수치로 직접 나눈 값 |
*2026년 9월 29일 기준으로 공식 페이지와 외부 평가 글을 읽고 정리한 분석입니다. 점수는 Anthropic의 자체 보고이고, 작업당 비용은 벤치마크 한 묶음의 결과라 내 작업과 다를 수 있습니다. 제가 직접 재현한 값은 아닙니다.*
작성자 소개