클로드 코드를 쓰다 보면 어느 날 사용량이 예상보다 빨리 차오른다는 것을 알게 됩니다. 그때 검색하면 토큰 절약을 내세운 깃허브 저장소가 4개쯤 눈에 띕니다. 스타 수가 수만 개인 것도 있어서 솔깃하지만, 각 README에는 “30% 절감”, “57% 절감” 같은 숫자가 저마다 다른 기준으로 적혀 있습니다. 이 글은 도구 4개를 토큰이 새는 곳 세 군데로 나눠 정리하고, 그 숫자를 어떻게 읽어야 하는지 초보자 눈높이로 풀어 봅니다.
목차
먼저 밝힙니다. 이 글은 각 저장소의 README와 평가 문서를 읽고 정리한 분석이고, 수치는 전부 저장소가 스스로 밝힌 값입니다. 제가 직접 돌려서 재현한 결과는 없습니다. 스타 수와 라이선스는 2026년 9월 29일에 GitHub에서 확인했습니다.
토큰은 어디서 새나요?
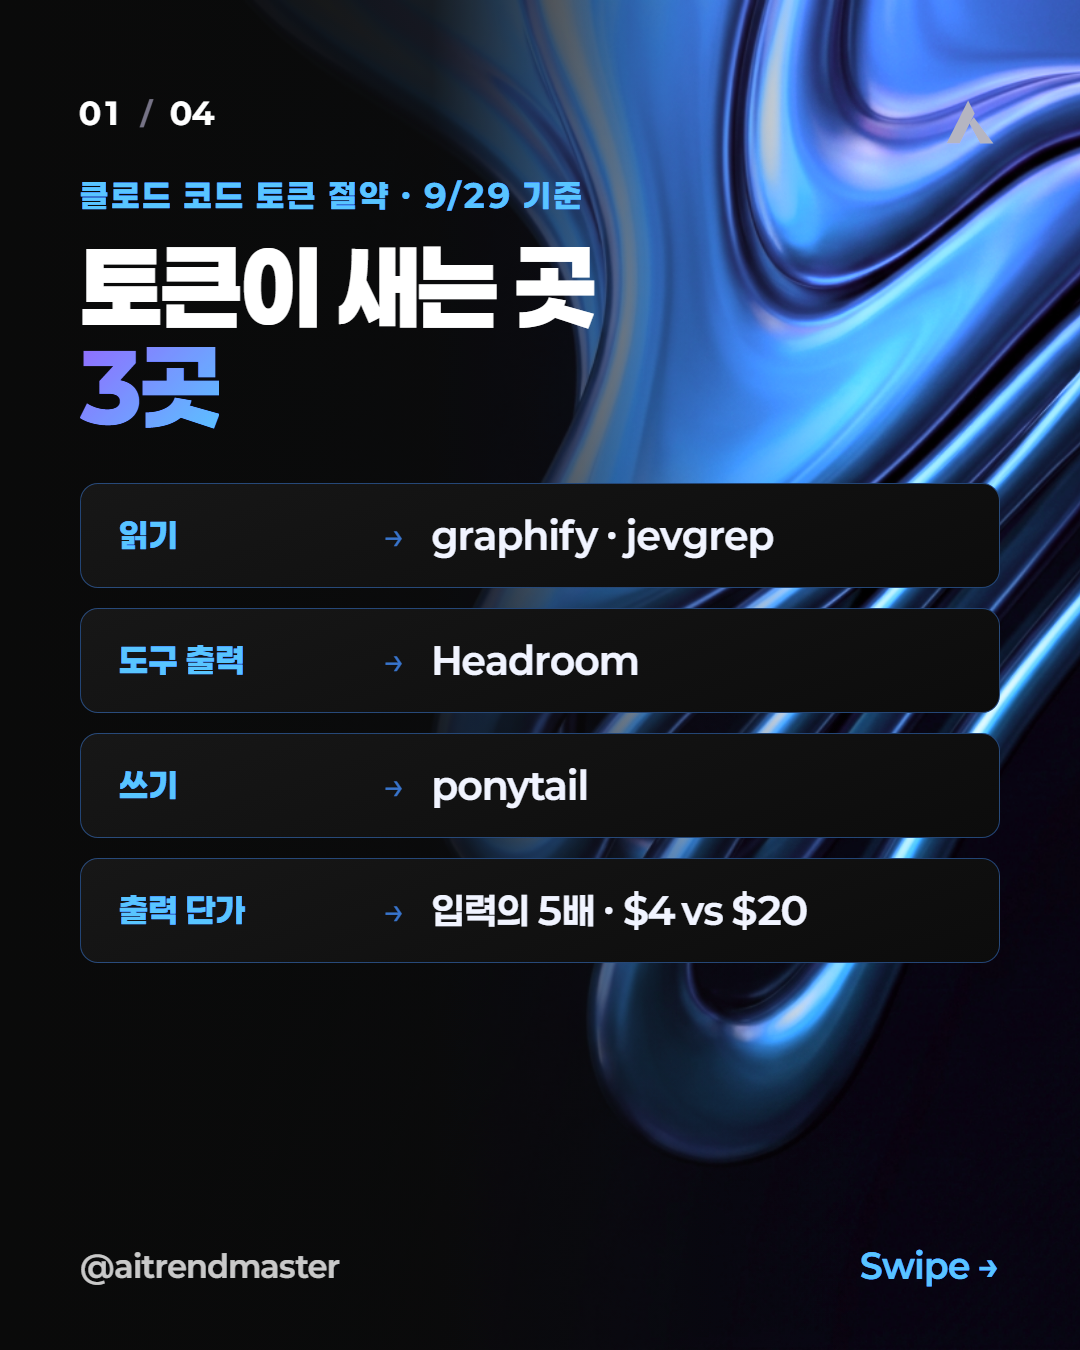
토큰 절약을 하려면 먼저 어디서 새는지를 알아야 합니다. 클로드 코드의 토큰은 크게 세 곳에서 나갑니다.
- 읽기: AI가 코드 파일을 통째로 읽을수록 입력 토큰이 늘어납니다.
- 도구 출력: 테스트 로그, 검색 결과, 긴 기록 같은 도구의 결과물이 그대로 대화에 실려 들어갑니다.
- 쓰기: AI가 답과 코드를 길게 쓸수록 출력 토큰이 늘어납니다. 오퍼스 5.5는 100만 토큰당 입력 4달러, 출력 20달러라서 출력이 5배 비쌉니다.
도구 4개는 이 세 곳 중 한 곳을 겨냥합니다. 아래 표로 먼저 훑어 보시고, 각 도구는 뒤에서 하나씩 설명하겠습니다.
| 도구 | 겨냥하는 곳 | 스타 수 | 라이선스 | 자체 표기 수치 |
|---|---|---|---|---|
| graphify | 읽기 | 약 12.2만 | Apache-2.0 | 절감 수치 미표기 |
| jevgrep | 읽기 | 1,457 | MIT | 10과제 총비용 28.6%↓ |
| Headroom | 도구 출력 | 약 7.4만 | Apache-2.0 | 시나리오 4개 21~57%↓ |
| ponytail | 쓰기 | 약 14.8만 | MIT | 비용 20%↓ (Haiku 4.5) |
읽기에서 새는 토큰을 줄이는 도구는 무엇인가요?
읽기 쪽 토큰 절약 도구는 두 개입니다. 접근 방식이 다릅니다.
graphify는 코드를 통째로 읽히는 대신 지식 그래프에 물어보게 하는 방식입니다. 도서관에서 책을 전부 펼쳐 읽는 대신 색인 카드부터 찾아보는 것과 비슷합니다. README는 절감률을 따로 밝히지 않습니다. 그래서 얼마나 줄어드는지는 붙여 본 사람이 재 봐야 압니다.
jevgrep은 “인증은 어디서 확인해?” 같은 질문을 던지면 관련 있는 파일과 발췌만 골라서 돌려주는 검색 도구입니다. 파일을 고르는 일을 별도의 AI 모델이 맡는데, 이 모델을 문서에서는 Jev라고 부릅니다. 이 Jev의 존재가 아래에서 다룰 숫자 해석의 핵심입니다.
도구 출력과 쓰기에서 새는 토큰은 어떻게 줄이나요?
Headroom은 로그, 검색 결과, 긴 대화 기록을 내 컴퓨터에서 압축한 다음 모델로 보냅니다. README의 예시 하나에서는 10,144토큰이 1,260토큰으로 줄었고, 자체 시나리오 4개에서는 21%, 30%, 42%, 57%의 절감을 보였다고 합니다. 같은 문서에는 반복이 많은 로그는 크게 줄지만 줄글이나 이미 촘촘한 출력은 거의 줄지 않는다는 설명도 있습니다. 설치 뒤에는 headroom wrap claude로 클로드 코드를 감싸서 씁니다.
ponytail은 AI가 필요한 만큼만 쓰도록 유도하는 스킬입니다. README에 따르면 Haiku 4.5로 12개 과제를 4번씩 돌린 자체 측정에서 코드 줄 수 54%, 토큰 22%, 비용 20%, 시간 27%가 줄었습니다. 여기서 눈여겨볼 것은 측정에 쓴 모델입니다. 오퍼스 5.5에서도 같은 폭으로 줄어드는지는 그 문서로는 알 수 없습니다. 설치는 /plugin marketplace add DietrichGebert/ponytail을 실행한 뒤 /plugin install ponytail@ponytail을 한 번 더 실행하는 두 단계입니다.
‘28.6% 절감’은 무슨 뜻인가요?
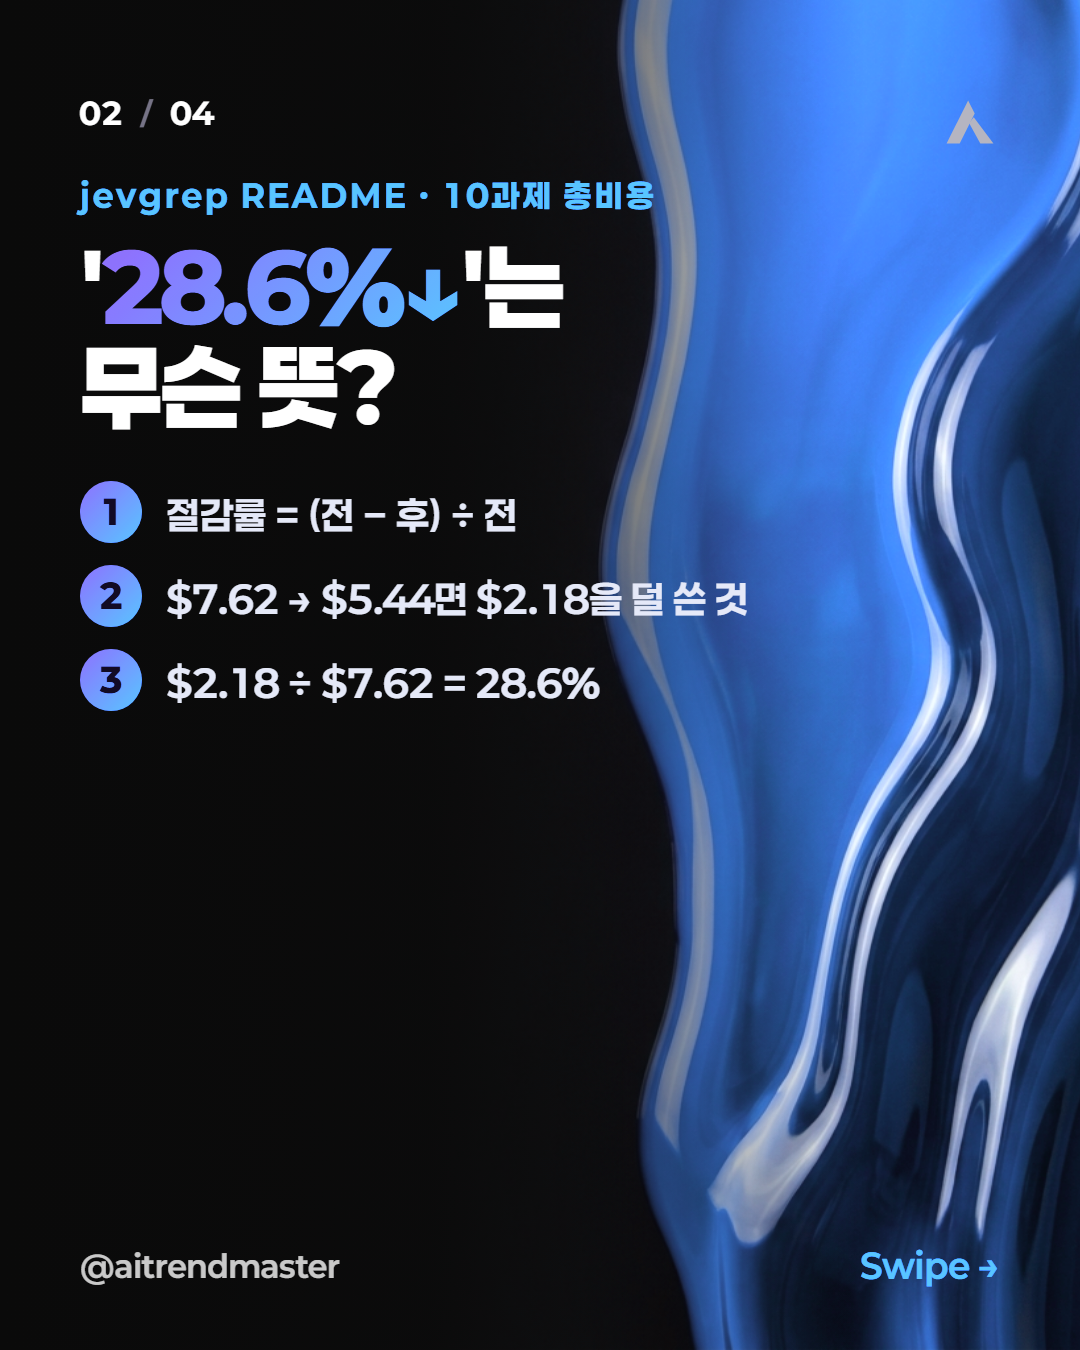
절감률은 초등학교 때 배운 계산입니다. 전에 쓰던 돈에서 지금 쓰는 돈을 뺀 값을, 전에 쓰던 돈으로 나눕니다.
- 절감률 = (전 − 후) ÷ 전
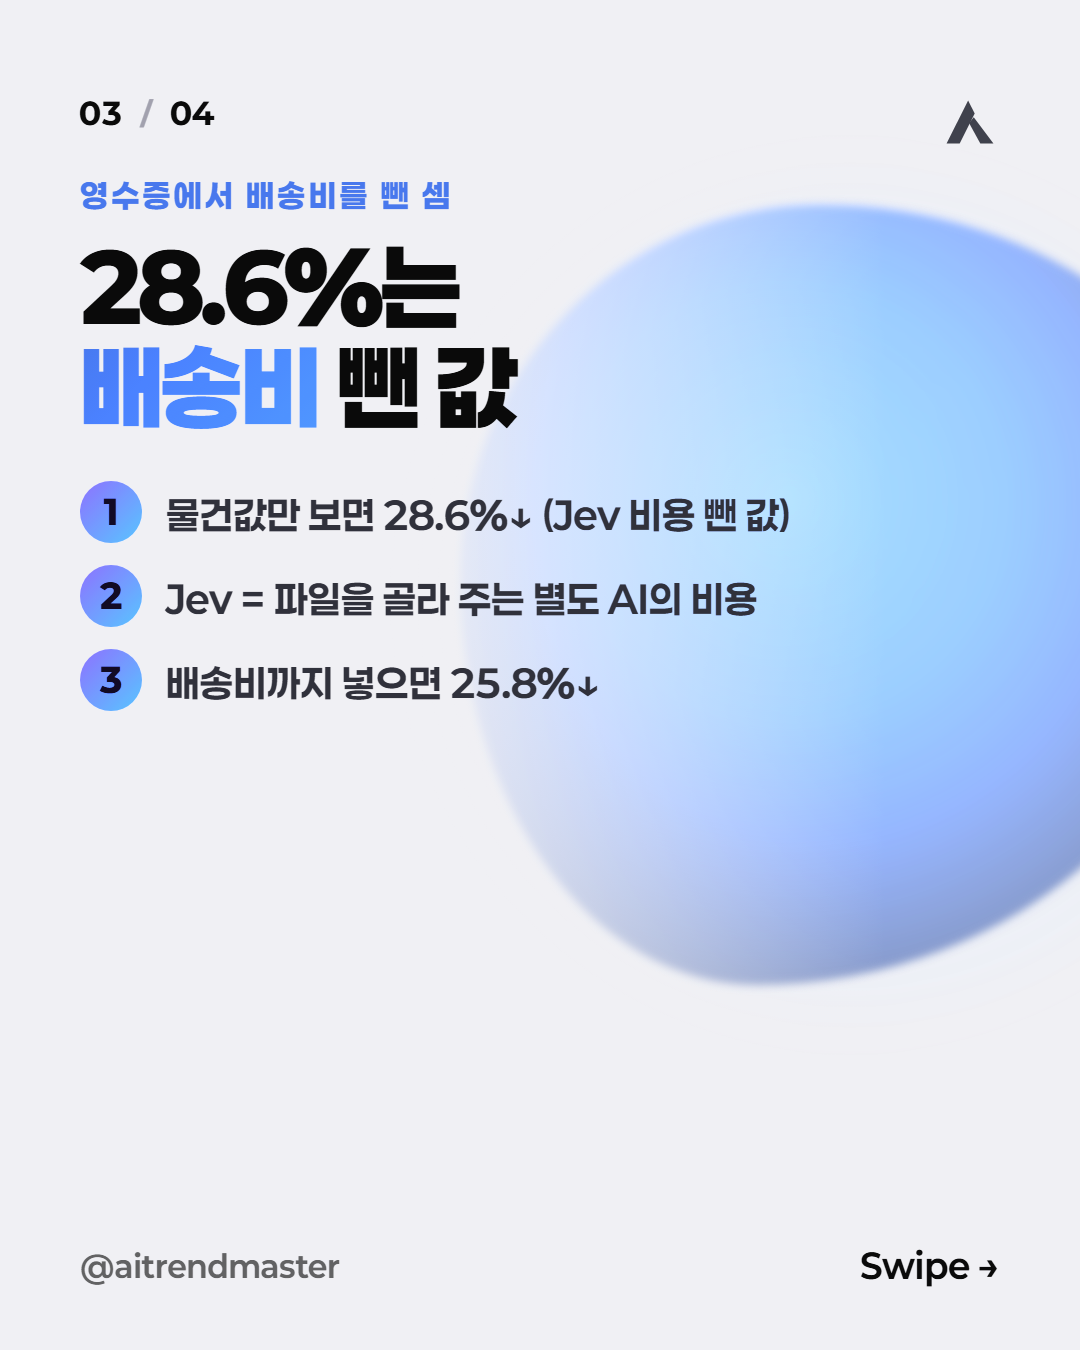
jevgrep README의 10과제 총비용은 7.62달러에서 5.44달러로 줄었습니다. 덜 쓴 돈은 7.62 빼기 5.44인 2.18달러이고, 이것을 처음 금액 7.62달러로 나누면 0.286, 즉 28.6%입니다. 쓰던 돈이 100원이었다면 71.4원만 쓰게 됐다는 이야기입니다.
같은 문서에서는 10개 과제 중 8개를 두 조건 모두 풀어서 성공률은 그대로였다고 밝힙니다. 돈을 아끼고 결과가 나빠졌다면 의미가 없으니, 절감률을 볼 때는 성공률을 항상 같이 봐야 합니다. 다만 이 10과제는 파이썬 과제를 골라 조정해 둔 것이고 한 번씩 측정한 값이라, 다른 프로젝트에서도 같은 폭이 나올 것이라는 근거는 아닙니다.
28.6%와 25.8%는 왜 다른가요?
쇼핑몰에서 물건값만 보고 싸다고 판단했는데 배송비를 더하면 덜 싼 경우와 같은 상황입니다. jevgrep의 28.6%는 코딩을 맡은 AI의 비용만 계산한 값입니다. 관련 파일을 골라 주는 Jev의 비용은 뺀 값입니다. Jev도 모델을 호출하는 일이라 돈이 들기 때문에, 이 비용까지 넣은 총비용 기준으로는 절감률이 25.8%입니다. README의 0.4.3 버전 재측정 값입니다.
| 기준 | 절감률 | Jev 비용 |
|---|---|---|
| 코딩 AI 비용만 | 28.6% | 제외 |
| 총비용(재측정) | 25.8% | 포함 |
두 숫자 모두 거짓말은 아닙니다. 무엇을 빼고 셌는지가 다를 뿐입니다. 한 가지 주의할 점은 두 값이 서로 다른 측정에서 나왔다는 것입니다. 28.6에서 25.8을 뺀 2.8이 곧 Jev 비용의 비중이라고 계산할 수는 없습니다. 최신 0.5.0 버전은 Jev 자체 비용이 0.4.3보다 약 59% 줄었지만, Sol과 Jev를 합친 총비용은 오히려 2~3% 높아졌다고 문서가 밝히고 있어서, 버전마다 결론이 달라질 수 있습니다.
테스트에 쓴 AI가 클로드가 아니라면 어떻게 읽나요?
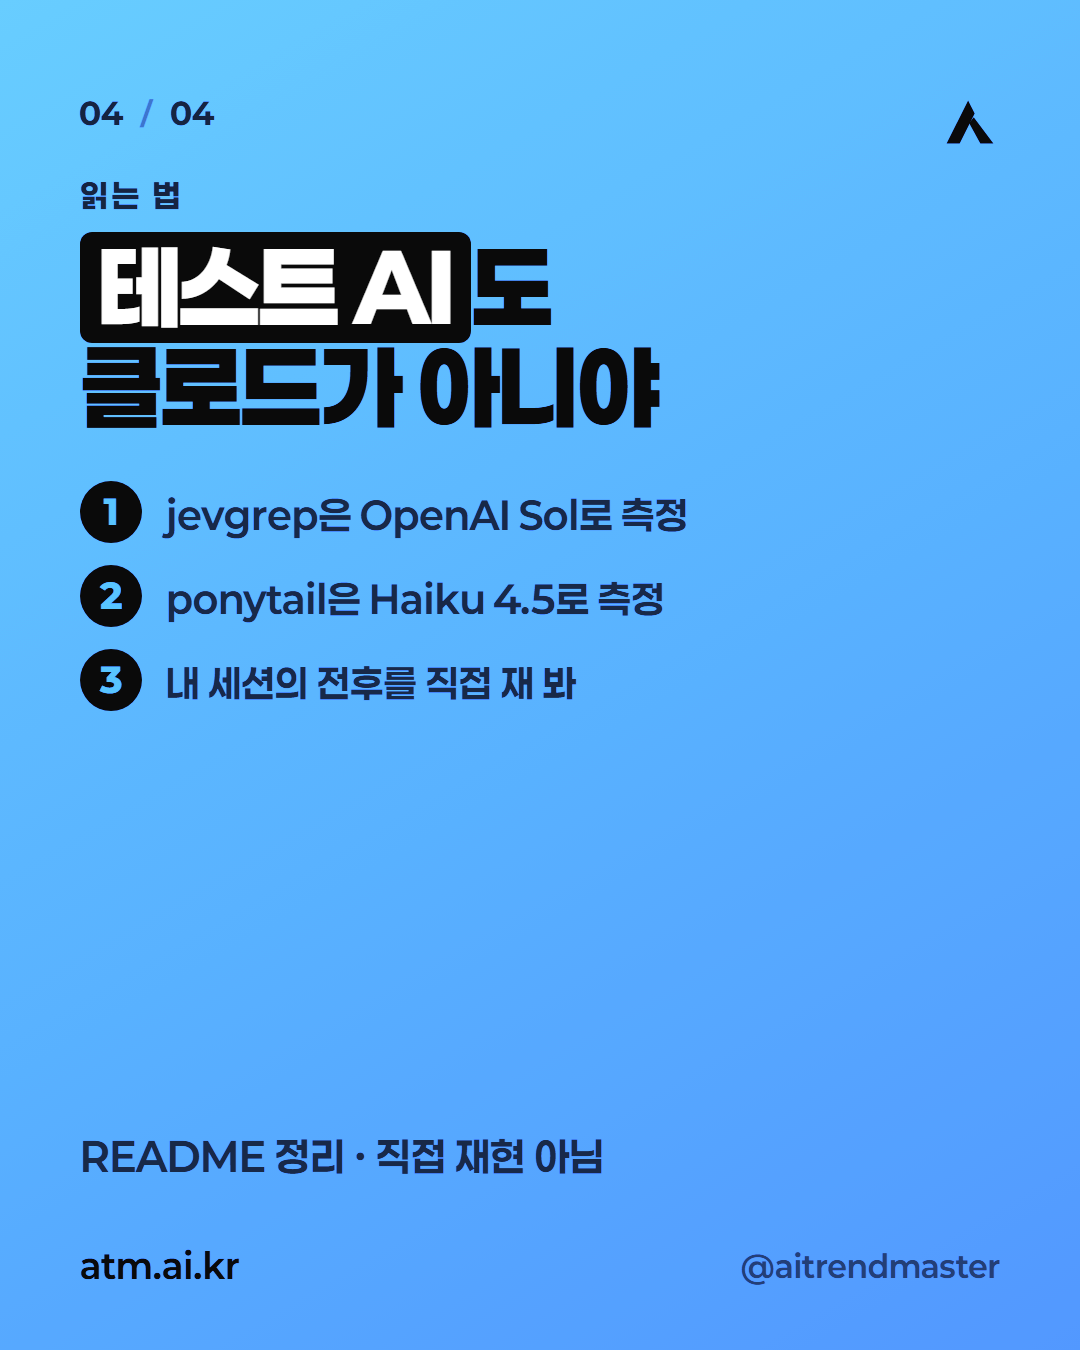
평가 문서를 보면 jevgrep 벤치마크에서 코딩을 맡은 모델은 openai/gpt-5.6-sol, 즉 OpenAI의 Sol입니다. 클로드로 잰 값이 아닙니다. ponytail은 Haiku 4.5, Headroom은 자체 시나리오 4개로 잰 값이라 세 도구의 수치는 조건이 서로 달라서 나란히 비교할 수 없습니다. 내 클로드 코드에서 같은 절감이 나온다는 보장도 없습니다.
토큰 절약은 어디서부터 시작하면 되나요?
토큰 절약 도구를 4개 전부 붙일 필요는 없습니다. 내 작업 패턴에서 가장 크게 새는 곳 하나만 골라 시작하는 편이 효과를 확인하기도 쉽습니다. 아래는 제가 README 내용을 바탕으로 정리한 시작점 표입니다. 효과가 검증된 처방이 아니라, 도구가 겨냥하는 위치에 맞춰 붙인 안내입니다.
| 이런 상황이라면 | 먼저 살펴볼 도구 | 이유 |
|---|---|---|
| 큰 저장소에서 파일을 자주 통째로 읽는다 | graphify, jevgrep | 읽는 양 자체를 줄이려는 도구 |
| 테스트·빌드 로그가 길게 쌓인다 | Headroom | 도구 출력 압축이 전문 |
| AI 답이 늘 필요 이상으로 길다 | ponytail | 쓰는 양을 줄이려는 스킬 |
| 어디서 새는지 아직 모른다 | 도구 없이 사용량 화면부터 | 원인을 모르면 처방도 어렵다 |
토큰 절약의 첫걸음은 도구가 아니라 측정입니다. 일주일 정도 평소처럼 쓰면서 세션마다 토큰 수와 비용을 메모해 두면, 위 표에서 내 상황이 어느 줄인지 금방 보입니다. 그다음 도구를 하나만 켜서 같은 종류의 작업을 다시 돌리고, 전과 후를 나란히 놓고 비교하면 됩니다. 여러 도구를 한꺼번에 켜면 어느 쪽이 효과를 냈는지 가려낼 수 없습니다.
한 가지 더 기억해 둘 점이 있습니다. 토큰 절약이 성공률을 깎아 먹으면 오히려 손해입니다. 줄어든 토큰 수만 보지 마시고, 결과가 여전히 맞는지도 같은 표에 적어 두세요.
도구를 붙이기 전에 확인할 것
- jevgrep은 Node 22 이상, macOS 또는 리눅스가 필요하고, 별도의 게이트웨이 키(OpenRouter 등)가 있어야 합니다. 이 키로 나가는 비용은 따로입니다.
- Headroom은 내 컴퓨터에서 압축한다고 설명하지만, 로그에 비밀 값이 섞여 있다면 무엇이 어디로 가는지 설치 전에 문서를 읽어 보시는 편이 안전합니다.
- 스타 수가 많다고 내 작업에 맞는 것은 아닙니다. 스타 수는 인기를 알려 줄 뿐 절감 효과를 알려 주지 않습니다.
토큰 절약 효과를 내 손으로 확인하는 방법은 단순합니다. 같은 작업을 도구 없이 한 번, 도구 하나만 켜고 한 번 돌려서 사용량 화면의 토큰 수, 비용, 결과가 맞았는지를 나란히 적습니다. 도구를 여러 개 한꺼번에 켜면 무엇이 효과를 냈는지 알 수 없으니 하나씩 켜야 합니다.
자주 묻는 질문
토큰 절약 도구는 무조건 설치하는 게 좋은가요?
그렇지 않습니다. 도구마다 겨냥하는 곳이 달라서, 내 토큰이 주로 새는 곳이 읽기인지 도구 출력인지 쓰기인지를 먼저 확인하는 편이 순서입니다. 도구를 하나 더 붙이면 설정과 점검 부담도 함께 늘어납니다.
28.6%와 25.8% 중 어느 숫자를 믿어야 하나요?
둘 다 정직한 숫자이고, 담고 있는 범위가 다릅니다. 실제로 내는 총비용을 알고 싶다면 Jev 비용까지 포함한 25.8% 쪽이 더 가깝습니다. 그마저도 자체 측정이라 내 환경의 값은 직접 재어 보셔야 합니다.
ponytail의 20% 비용 절감을 오퍼스 5.5에도 기대해도 되나요?
문서에 적힌 측정은 Haiku 4.5 기준이라 알 수 없습니다. 오퍼스 5.5는 출력 단가가 높아서 쓰는 양을 줄이는 방식이 더 큰 효과를 낼 여지는 있지만, 이는 추정일 뿐 확인된 값이 아닙니다.
오늘 나온 도구 바로가기
- graphify 저장소 페이지 — Apache-2.0, 지식 그래프로 코드 질의
- jevgrep 저장소 페이지 — MIT, 관련 파일과 발췌를 골라 돌려주는 검색 도구
- Headroom 저장소 페이지 — Apache-2.0, 도구 출력 압축
- ponytail 저장소 페이지 — MIT, 필요한 만큼만 쓰게 하는 스킬
- 오퍼스 5.5 단가 안내 — 입력 4달러, 출력 20달러(100만 토큰당)
- AI 자동화 비용 손익계산서 — 자동화 비용을 직접 따져 본 글
- 오퍼스 5.5 vs 아스트라 비교 — 제가 직접 돌려 본 네 과제 기록
출처
| 항목 | 출처 |
|---|---|
| 스타 수·라이선스 | GitHub REST (2026-09-29 확인) |
| 절감 수치 | 각 저장소 README와 평가 문서의 자체 표기 |
| 28.6%·25.8% | jevgrep README·평가 문서 (Sol=openai/gpt-5.6-sol 기재) |
| 오퍼스 5.5 단가 | Anthropic 공식 발표 페이지 (2026-09-29 확인) |
*2026년 9월 29일 기준으로 저장소 문서를 읽고 정리한 글입니다. 제가 직접 돌려 확인한 것은 스타 수와 라이선스, 문서 속 수치의 산수를 다시 계산한 부분까지이고, 절감 효과를 재현하지는 않았습니다. 각 저장소와는 제휴 관계가 없습니다.*
작성자 소개