UC버클리와 Snorkel AI가 만든 에이전트 벤치마크 ALE(Agents’ Last Exam)에서 GPT-5.5가 1위와 2위를, 클로드 Fable 5가 3위를 차지했습니다. 그런데 가장 어려운 문제 구간에서는 1위도 3위도 거의 다 0점이었습니다. 더 흥미로운 건 벤치마크 팀이 직접 내놓은 후속 분석입니다. 같은 모델이라도 어떤 도구연결 구조, 즉 에이전트 하네스로 감싸느냐에 따라 점수가 모델을 바꾼 것보다 더 크게 흔들렸다는 내용입니다. 이 글은 그 벤치마크 결과를 원문 중심으로 정리하고, ATM이 운영 중인 에이전트 17개의 실제 툴 권한을 열어 같은 패턴이 있는지 직접 대조해 본 기록입니다.
목차
UC버클리가 만든 ‘진짜 업무’ 시험은 어떻게 생겼나요?
ALE는 UC버클리 RDI와 Snorkel AI가 250명이 넘는 산업 전문가와 함께 설계한 벤치마크입니다. O*NET과 SOC 직업 분류를 기반으로 55개 세부 산업을 13개 클러스터로 묶고, 그 안에서 실제 업무 형태를 흉내 낸 과제를 1,500개 넘게(목표는 5,000개) 모았습니다. 과제는 난이도에 따라 근접(Near-Term), 풀스펙트럼(Full-Spectrum), 라스트-엑스잼(Last-Exam) 세 단계로 나뉘는데, 이름 그대로 마지막 단계일수록 실제 업무에 가깝고 어렵습니다. 챗봇에 질문 하나를 던지는 식의 평가가 아니라, 여러 단계를 거쳐야 끝나는 작업을 에이전트에게 그대로 맡기고 채점하는 방식입니다.
리더보드 1위는 GPT-5.5인데, 왜 숫자가 매체마다 다른가요?
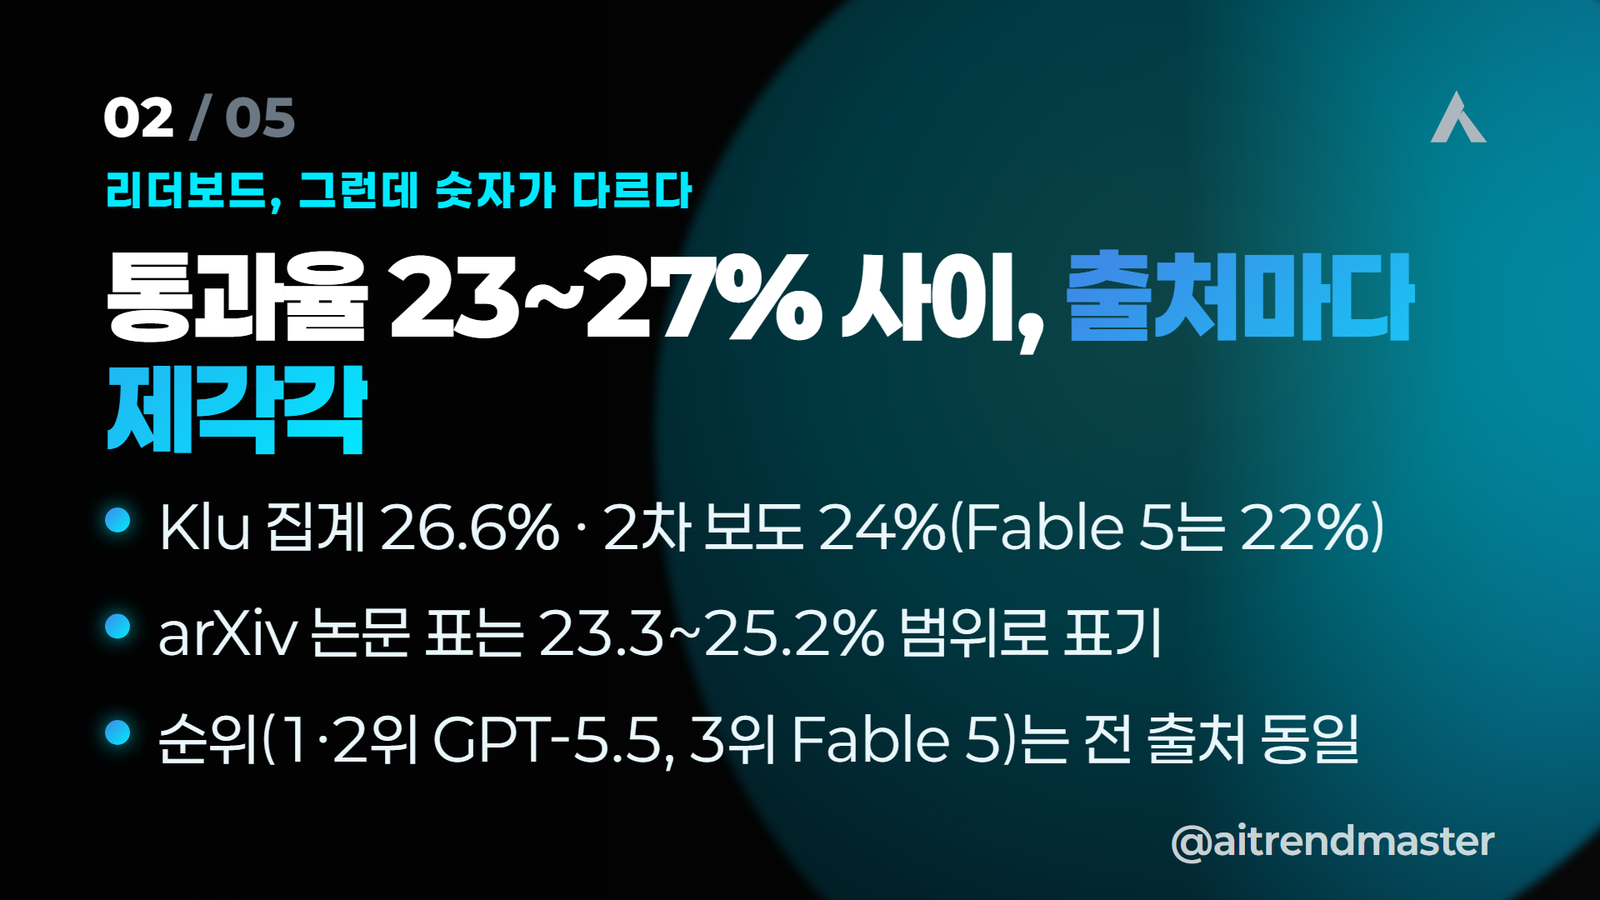
Codex 하네스로 실행한 GPT-5.5가 리더보드 1위와 2위를 차지했고, 클로드 Fable 5는 3위로 집계됐습니다. 다만 정확한 통과율은 이를 다룬 매체마다 조금씩 다릅니다. 집계 사이트 Klu는 26.6%로, 2차 보도는 GPT-5.5 24%, Fable 5 22%로, 논문 표 자체는 23.3~25.2% 구간으로 적고 있습니다. 숫자가 엇갈리는 이유까지 논문이 밝히지는 않지만, 순위(1위와 2위 GPT-5.5, 3위 Fable 5)는 모든 출처에서 동일합니다.
| 출처 | GPT-5.5 통과율 | 비고 |
|---|---|---|
| Klu 집계 | 26.6% | 벤치마크 집계 사이트 |
| 2차 보도(VentureBeat 재배포) | 24%(Fable 5는 22%) | 보도 시점 스냅샷 |
| arXiv 논문 표 | 23.3~25.2% | 범위로 표기 |
가장 어려운 문제에서는 왜 둘 다 0점에 가까웠나요?
가장 어려운 라스트-엑스잼 구간에서는 주요 모델 평균 통과율이 2.6%였습니다. 리더보드 1위인 GPT-5.5와 3위인 Fable 5를 포함한 대다수 모델이 이 구간에서 0점을 받았습니다. 전체 리더보드에서는 격차가 뚜렷했던 두 모델이, 난이도가 “실제 업무”에 가까워질수록 격차 자체가 무의미해질 만큼 같이 풀지 못했다는 뜻입니다. 1위 모델이라는 표시가 “이 작업을 믿고 맡겨도 된다”는 보증은 아니라는 걸 숫자로 보여주는 대목입니다.
에이전트 하네스가 뭐길래 모델 선택보다 더 크게 흔든다는 건가요?
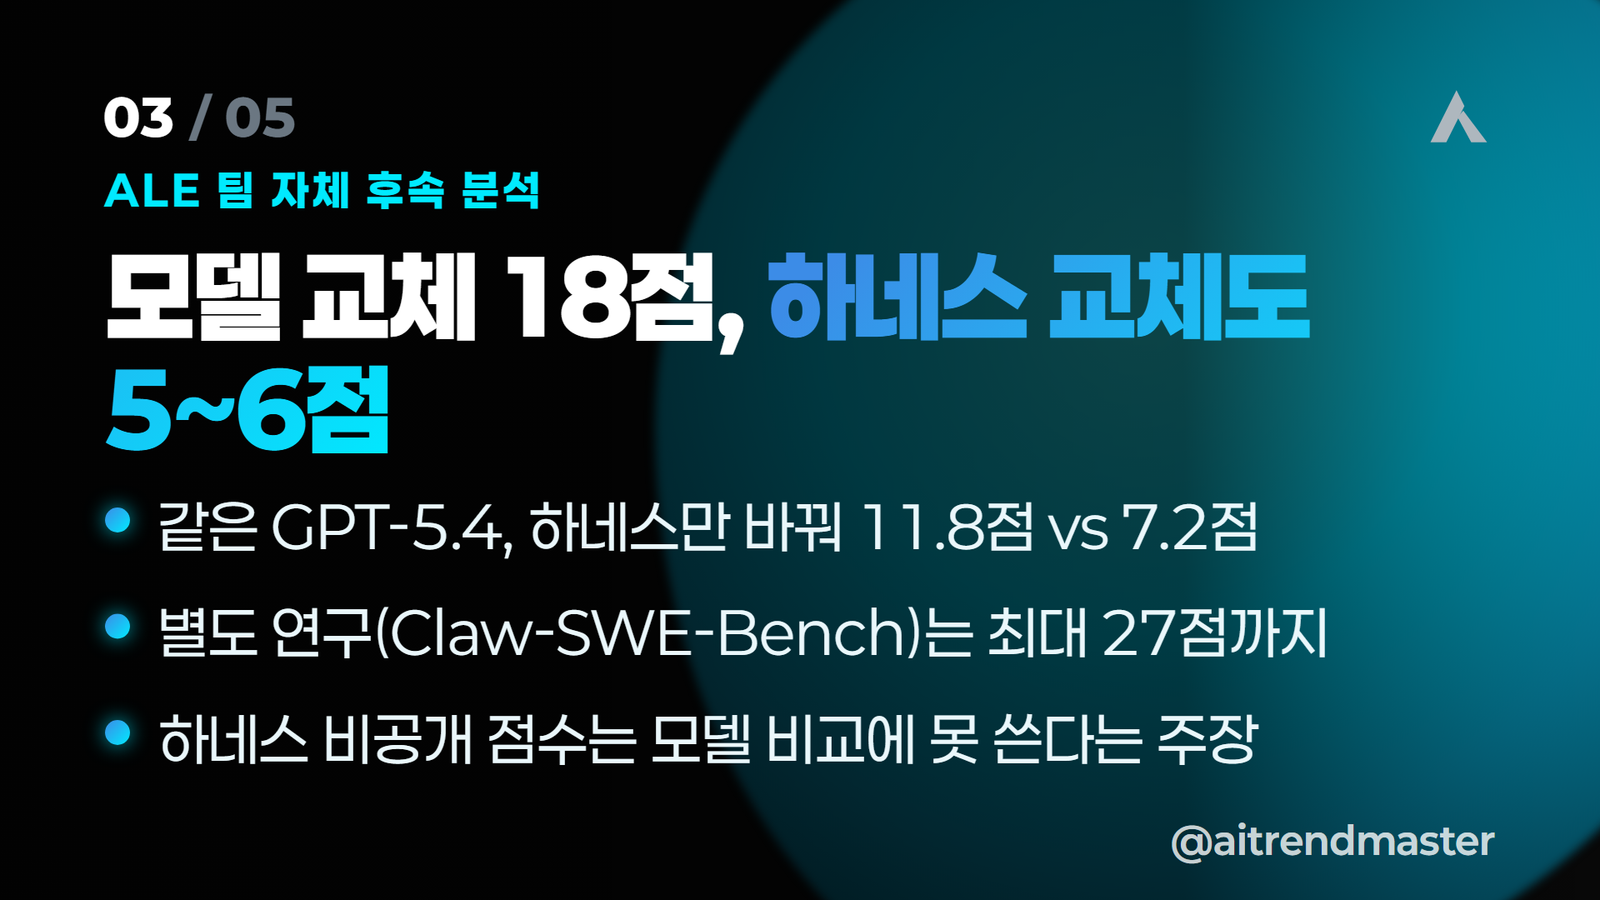
에이전트 하네스는 모델 자체가 아니라, 모델에게 어떤 도구를 쥐여주고 어떤 순서로 작업을 시키는지를 정의하는 연결 구조입니다. ALE 팀이 2026년 6월 11일 올린 후속 분석(“Does the Harness Matter? Lessons from ALE-Claw”)에 따르면, 하네스를 OpenClaw로 고정하고 모델만 바꾸면 점수가 18.0점 차이 났습니다. 반대로 모델을 고정하고 하네스만 바꿔도 5~6점이 흔들렸습니다. 같은 GPT-5.4 모델인데도 ALE-Claw 하네스에서는 11.8점, Codex 하네스에서는 7.2점으로, 하네스만 바꿔서 4.6점이 벌어진 사례도 논문 표에 나와 있습니다.
비슷한 결론은 다른 연구에서도 나왔습니다. 별도 연구인 Claw-SWE-Bench는 코딩 과제에서 모델은 그대로 두고 하네스만 바꿔도 Pass@1 점수가 최대 27점까지 흔들린다고 보고했습니다. 이 때문에 “실행 하네스를 공개하지 않은 에이전트 벤치마크 점수는 모델 간 비교에 쓸 수 없다”는 주장도 함께 나왔습니다. ALE 리더보드 자체도 스냅샷마다 수치가 바뀝니다. 같은 Opus 4.7 구성이 한 스냅샷에서는 18.4%, 다른 스냅샷에서는 20%로 집계됐습니다. 숫자 하나를 고정값처럼 받아들이면 안 되는 이유입니다.
| 바뀐 것 | 점수 변화 | 출처 |
|---|---|---|
| 하네스 고정, 모델만 교체 | 최대 18.0점 차이 | ALE-Claw 후속 분석 |
| 모델 고정, 하네스만 교체 | 5~6점 차이 | ALE-Claw 후속 분석 |
| 같은 GPT-5.4, 하네스만 교체 | 11.8점 vs 7.2점(4.6점차) | ALE 논문 표 |
| 같은 모델, 하네스만 교체(별도 연구) | 최대 27점 차이 | Claw-SWE-Bench |
제 에이전트 17개를 다시 열어 봤습니다(같은 역할인데 하네스가 다른 경우)
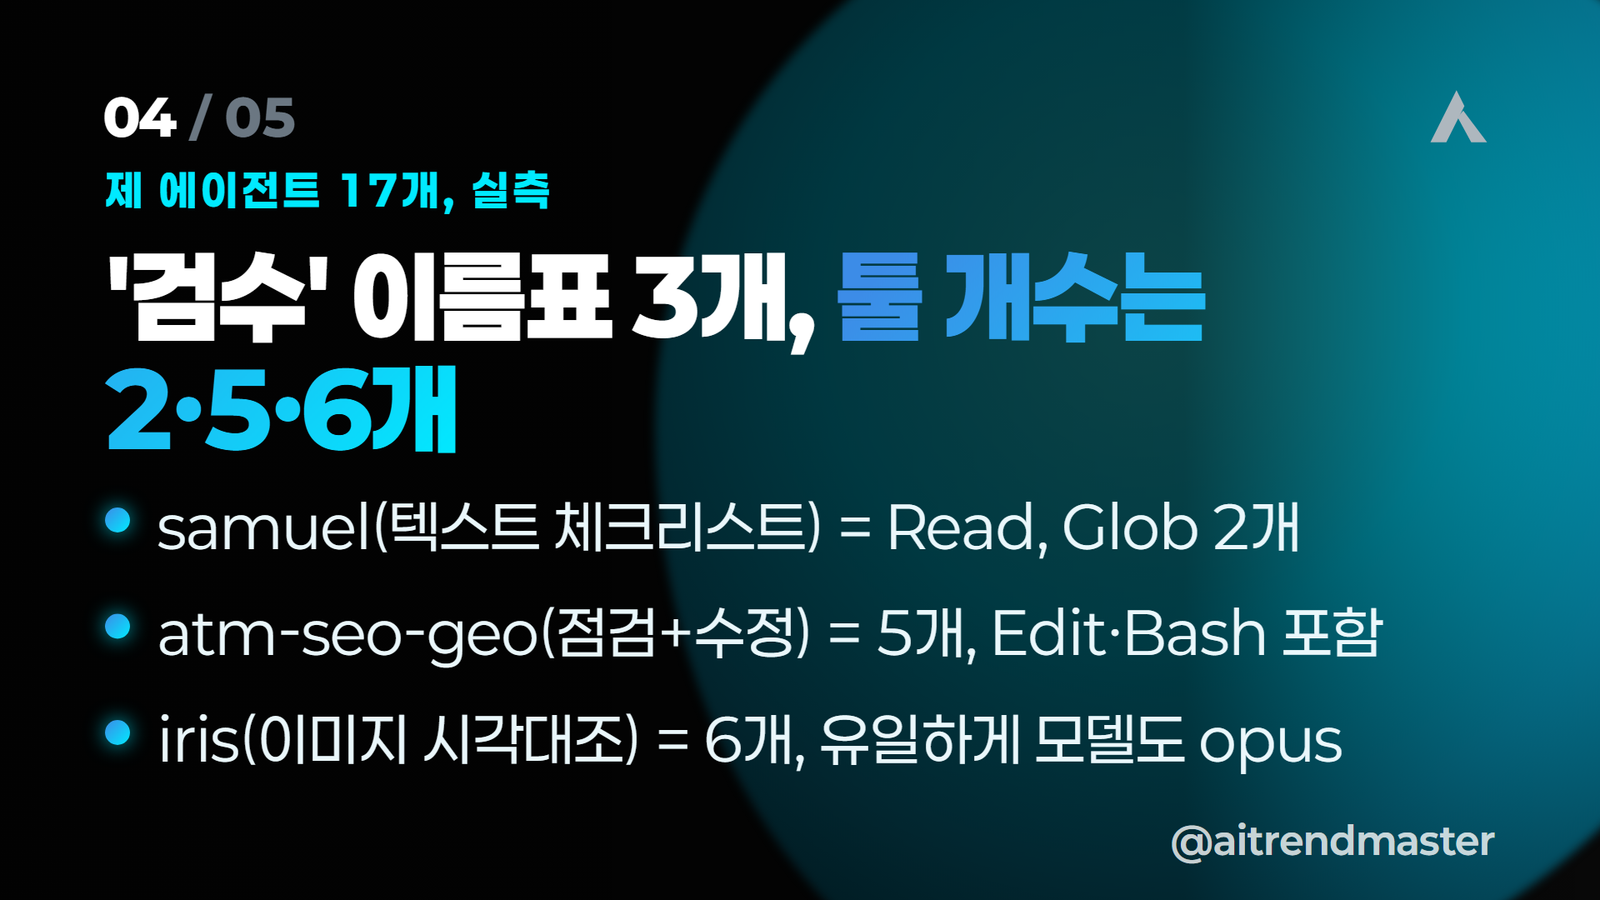
여기까지는 전부 바깥의 벤치마크 이야기입니다. ATM을 혼자 운영하면서 쓰는 에이전트 설정 파일은 .claude/agents/ 아래 17개가 있는데, 모델 선택 기준은 전에 다룬 적이 있습니다. 그 글은 “같은 작업에 어떤 모델을 쓰느냐”를 봤다면, 이번에는 “같은 역할에 어떤 도구를 쥐여주느냐”를 봤습니다. 이번에 17개 파일을 다시 열어 tools: 항목만 따로 뽑아 보니, 이름에 “검수”가 들어간 역할이 세 개 있었고 허용된 도구 개수가 전부 달랐습니다.
| 에이전트 | 검수 대상 | 모델 | 허용 도구(하네스) | 도구 개수 |
|---|---|---|---|---|
| samuel | 콘텐츠 텍스트 체크리스트 | sonnet | Read, Glob | 2개 |
| atm-seo-geo | SEO와 GEO 점검, 자연 문장 수정 | sonnet | Read, Edit, Glob, Grep, Bash | 5개 |
| iris | 디자인 결과물 시각 대조 | opus | Read, Write, Edit, Glob, Grep, Bash | 6개 |
samuel은 글 파일을 읽고 체크리스트와 대조해 통과나 보류만 보고하면 되는 역할이라 읽기 도구 두 개로 끝납니다. atm-seo-geo는 점검 스크립트를 직접 돌리고 문장을 고쳐 다시 저장해야 해서 Edit과 Bash가 필요합니다. iris는 렌더링된 이미지를 기준 샘플과 시각으로 대조하고, 결함을 찾으면 재렌더까지 지시해야 해서 도구가 가장 많고, 셋 중 유일하게 모델도 opus로 다릅니다. 셋 다 이름은 “검수”지만 실제로 하는 일의 모양이 다르기 때문에 쥐여준 도구도 다른 셈입니다. 이건 ALE 후속 분석이 말한 “모델이 같아도 하네스가 다르면 결과가 달라진다”는 문장을 거꾸로 읽은 것과 비슷합니다. 같은 모델을 써도 하네스가 다르면 결과가 갈린다면, 애초에 하는 일이 다른 역할에 같은 하네스를 물려주는 쪽이 더 이상한 설계라는 뜻이기도 합니다.
1인 운영자 입장에서, 뭘 다르게 해야 하나요?
이 에이전트 하네스 벤치마크에서 가져갈 수 있는 실무 포인트는 두 가지입니다. 첫째, 에이전트 성능을 점검할 때 “어떤 모델을 쓰는지”만 보고 끝내지 않는 겁니다. 같은 모델이라도 도구 권한과 지시 구조를 어떻게 짰는지에 따라 결과가 꽤 크게 갈릴 수 있다는 걸 벤치마크 숫자가 보여줬습니다. 둘째, 역할마다 필요한 도구만 쥐여주는 게 단순히 보안을 위한 선택이 아니라 성능과도 관련된 선택일 수 있다는 점입니다. samuel에게 Bash를 쥐여준다고 검수 품질이 더 좋아지는 건 아니고, 오히려 그 역할에 안 맞는 도구는 안 쥐여주는 쪽이 이 벤치마크가 말한 “하네스를 작업에 맞게 설계한다”는 원칙에 가깝습니다.
반대로 1위 모델이라는 타이틀 자체를 과신하지 않는 것도 같은 결론에서 나옵니다. 가장 어려운 구간에서는 1위도 3위도 거의 다 0점이었다는 사실은, 벤치마크 리더보드 순위를 “이 모델을 쓰면 어려운 일도 믿고 맡길 수 있다”는 뜻으로 확대 해석하면 안 된다는 걸 보여줍니다.
자주 묻는 질문
에이전트 하네스를 바꾸면 무조건 점수가 좋아지나요?
아닙니다. ALE-Claw 후속 분석은 하네스에 따라 점수가 “달라진다”는 것이지 “항상 좋아진다”는 뜻이 아닙니다. 어떤 하네스가 어떤 과제에 더 잘 맞는지는 과제 성격에 따라 다르고, 이 글에서 인용한 수치도 특정 모델과 특정 과제 조합에서 관측된 차이입니다.
ATM의 에이전트 3개 비교는 벤치마크처럼 통제된 실험인가요?
아닙니다. 이 글의 ATM 부분은 반복 테스트나 점수 비교가 아니라, 실제 운영 중인 설정 파일을 열어 도구 목록을 그대로 옮겨 적은 관찰입니다. ALE 벤치마크처럼 같은 과제에 하네스만 바꿔 가며 점수를 측정한 게 아니라는 점을 분명히 해 둡니다.
출처
| 구분 | 내용 | 확인일 |
|---|---|---|
| 1차 | ALE 팀 후속 분석(Does the Harness Matter? Lessons from ALE-Claw) | 2026-11-08 |
| 1차 | Agents’ Last Exam 논문(arXiv 2606.05405) | 2026-11-08 |
| 2차 보도 | VentureBeat 재배포(GPT-5.5 리더보드 보도) | 2026-11-08 |
| 참고 연구 | Claw-SWE-Bench(하네스 설계가 코딩 에이전트 점수를 바꾼다) | 2026-11-08 |
| 자체 확인 | 소넷 5.5와 오퍼스 5.5, 단가는 절반인데 작업당 비용은 왜 더 올까(모델 선택 기준, 2026-10-15), .claude/agents/ 17개 설정 파일 직접 확인 |
2026-11-08 |
*이 글에서 인용한 통과율 수치는 출처마다 값이 다르며(Klu 26.6%, 2차 보도 24%, 논문 표 23.3~25.2%), 이 글은 그 범위를 그대로 보여주는 선에서 멈추고 하나의 값으로 단정하지 않았습니다. ALE 리더보드 자체도 스냅샷마다 수치가 바뀌는 벤치마크이므로, 특정 시점의 순위를 고정값으로 받아들이지 않는 걸 권합니다. ATM 에이전트 3개 비교는 통제된 성능 실험이 아니라 실제 운영 중인 설정 파일을 열어 본 관찰이며, 도구 개수가 많다고 해당 역할의 품질이 더 낫다는 뜻으로 쓰지 않았습니다.*
작성자 소개